Benchmarki modeli
Ten sam skill, to samo polecenie /security-audit, bez podpowiedzi o błędzie. Zmieniamy tylko model i agenta. Scorer sprawdza raport automatycznie i ściśle: liczy się znalezisko wskazujące linie, które zmieniła publiczna poprawka.
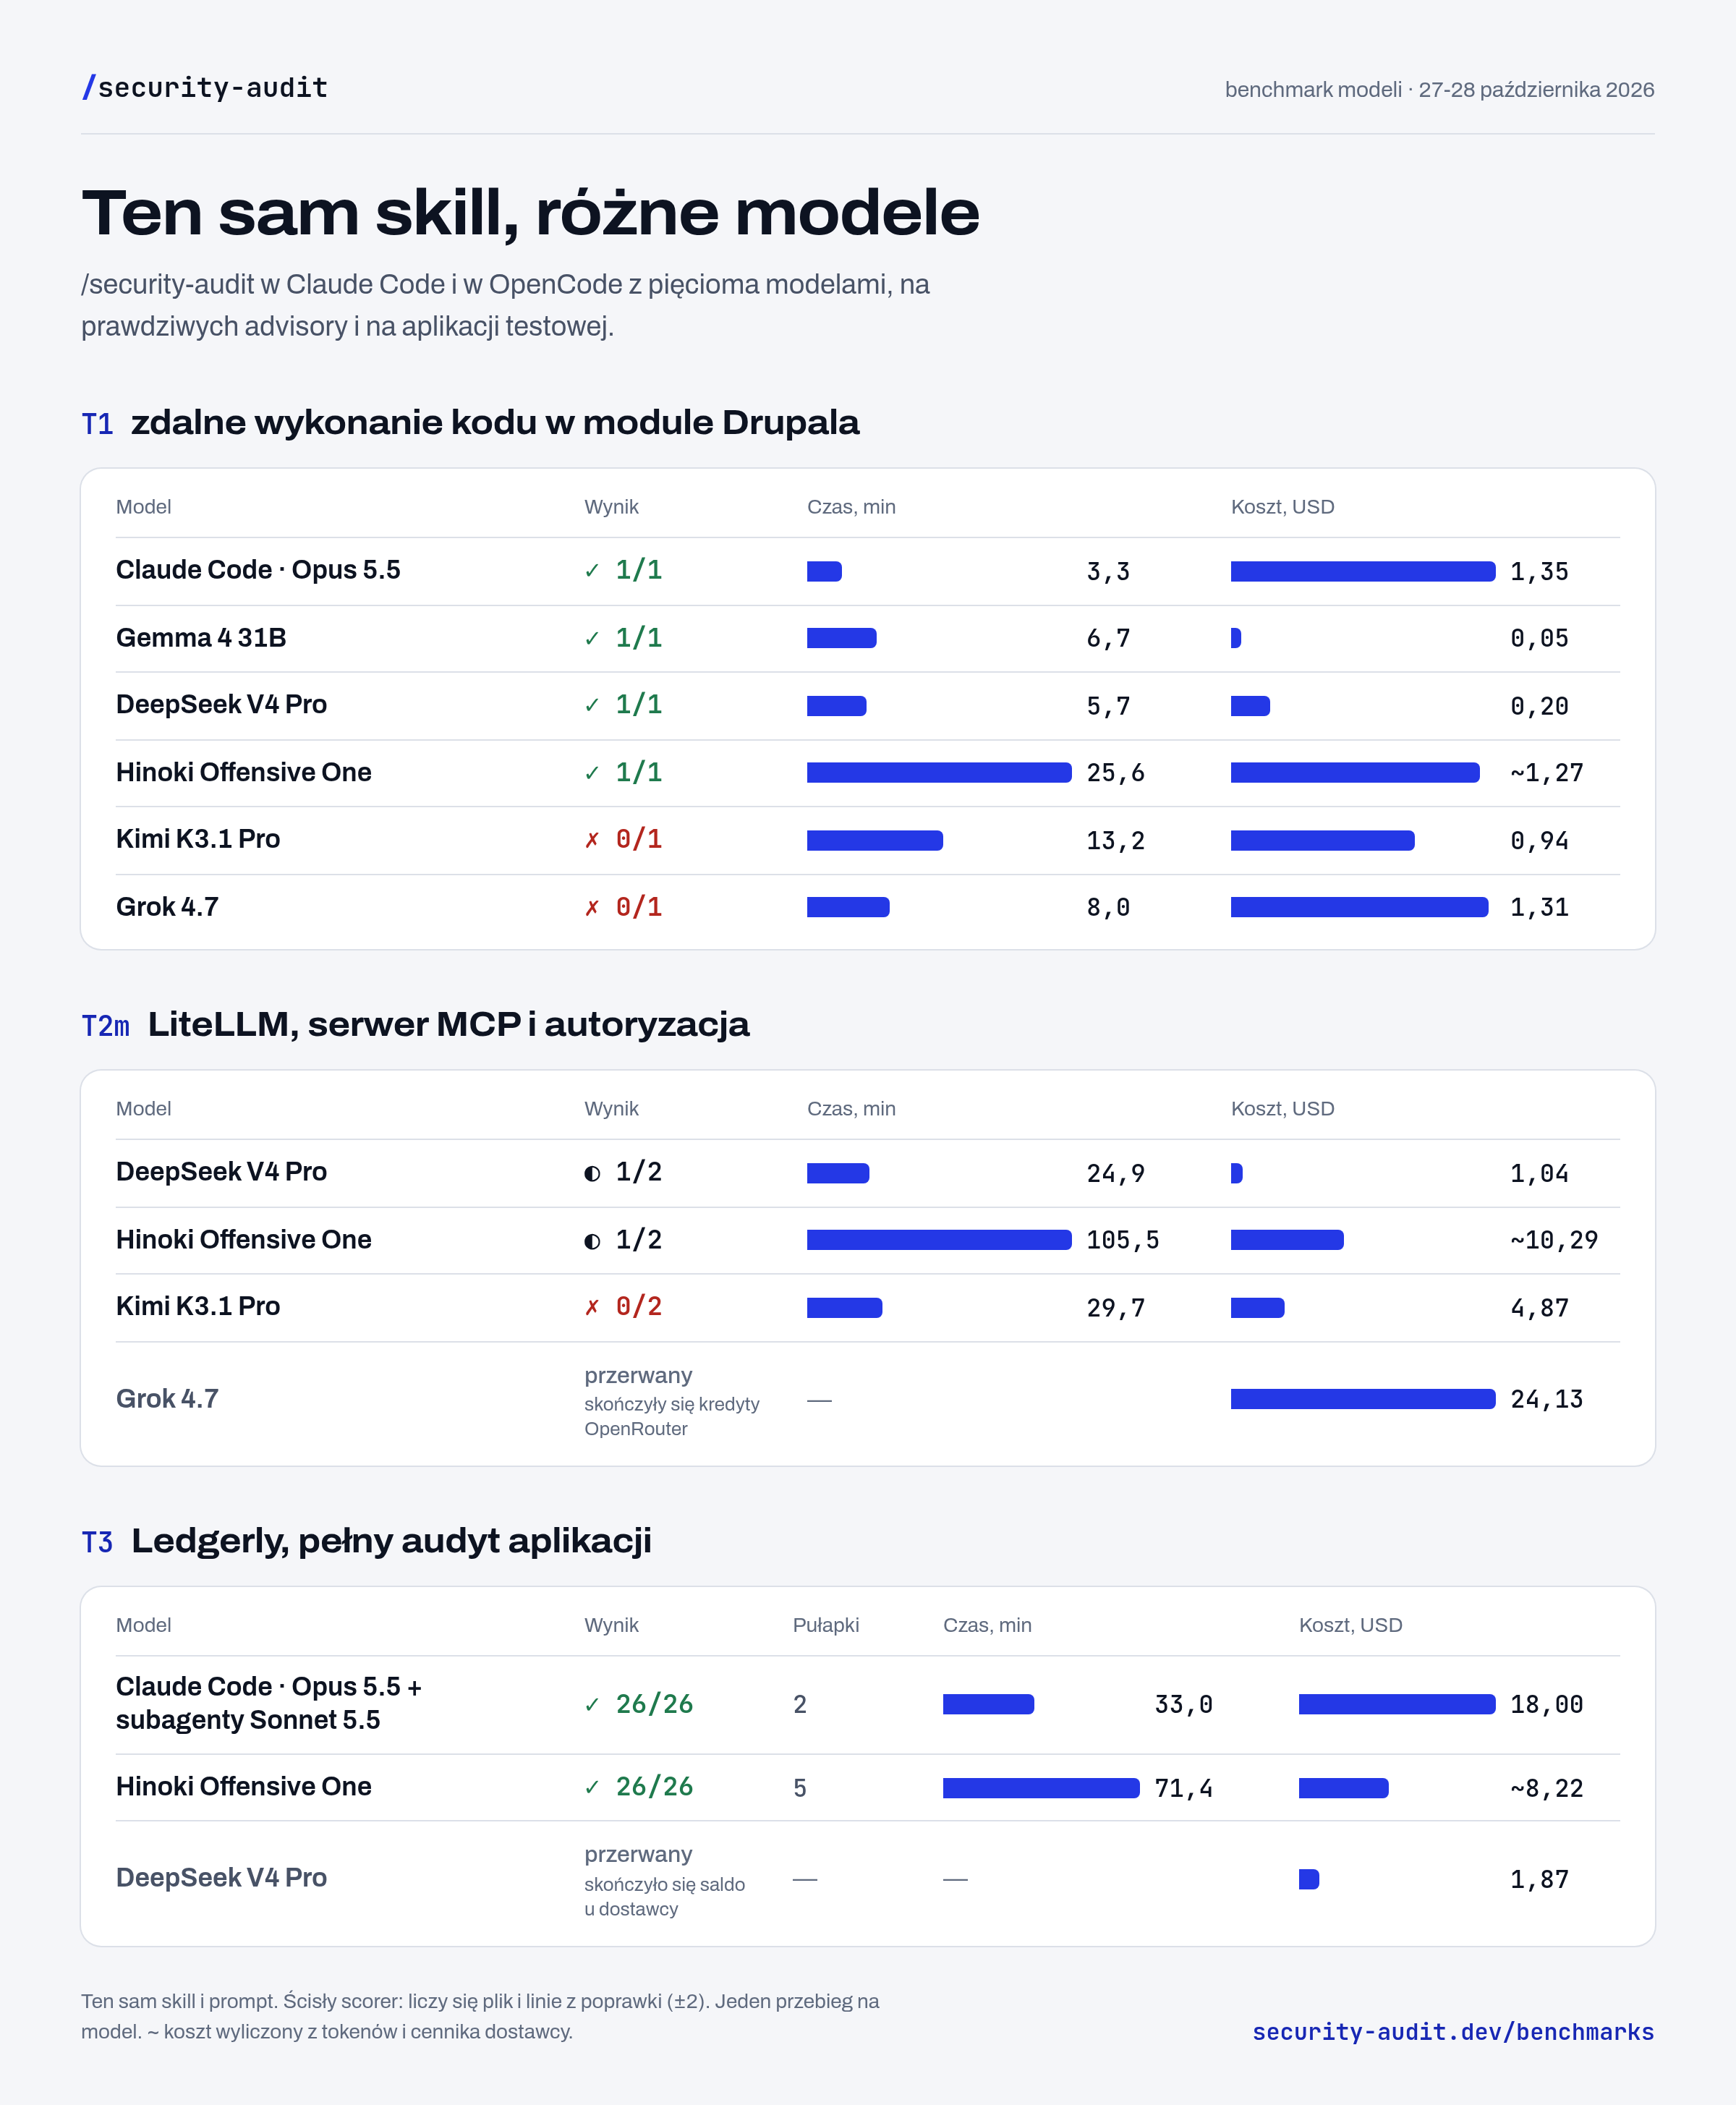
- T1zdalne wykonanie kodu w module Drupala4 z 6 konfiguracji wskazało linie poprawki
- T2mLiteLLM, serwer MCP i autoryzacja1 z 2 advisory: DeepSeek i Hinoki, drugie poza zakresem
- T3Ledgerly, pełny audyt aplikacji26/26: Claude Code i Hinoki w OpenCode
- T4py-clinic w Codex CLI17/18 bez strażnika, 12/18 ze strażnikiem
Przebiegi z 27 i 28 października 2026, po jednym na model i cel. Szczegóły metody i zastrzeżenia są na dole strony. Wszystkie liczby każdego przebiegu: wyniki per model.
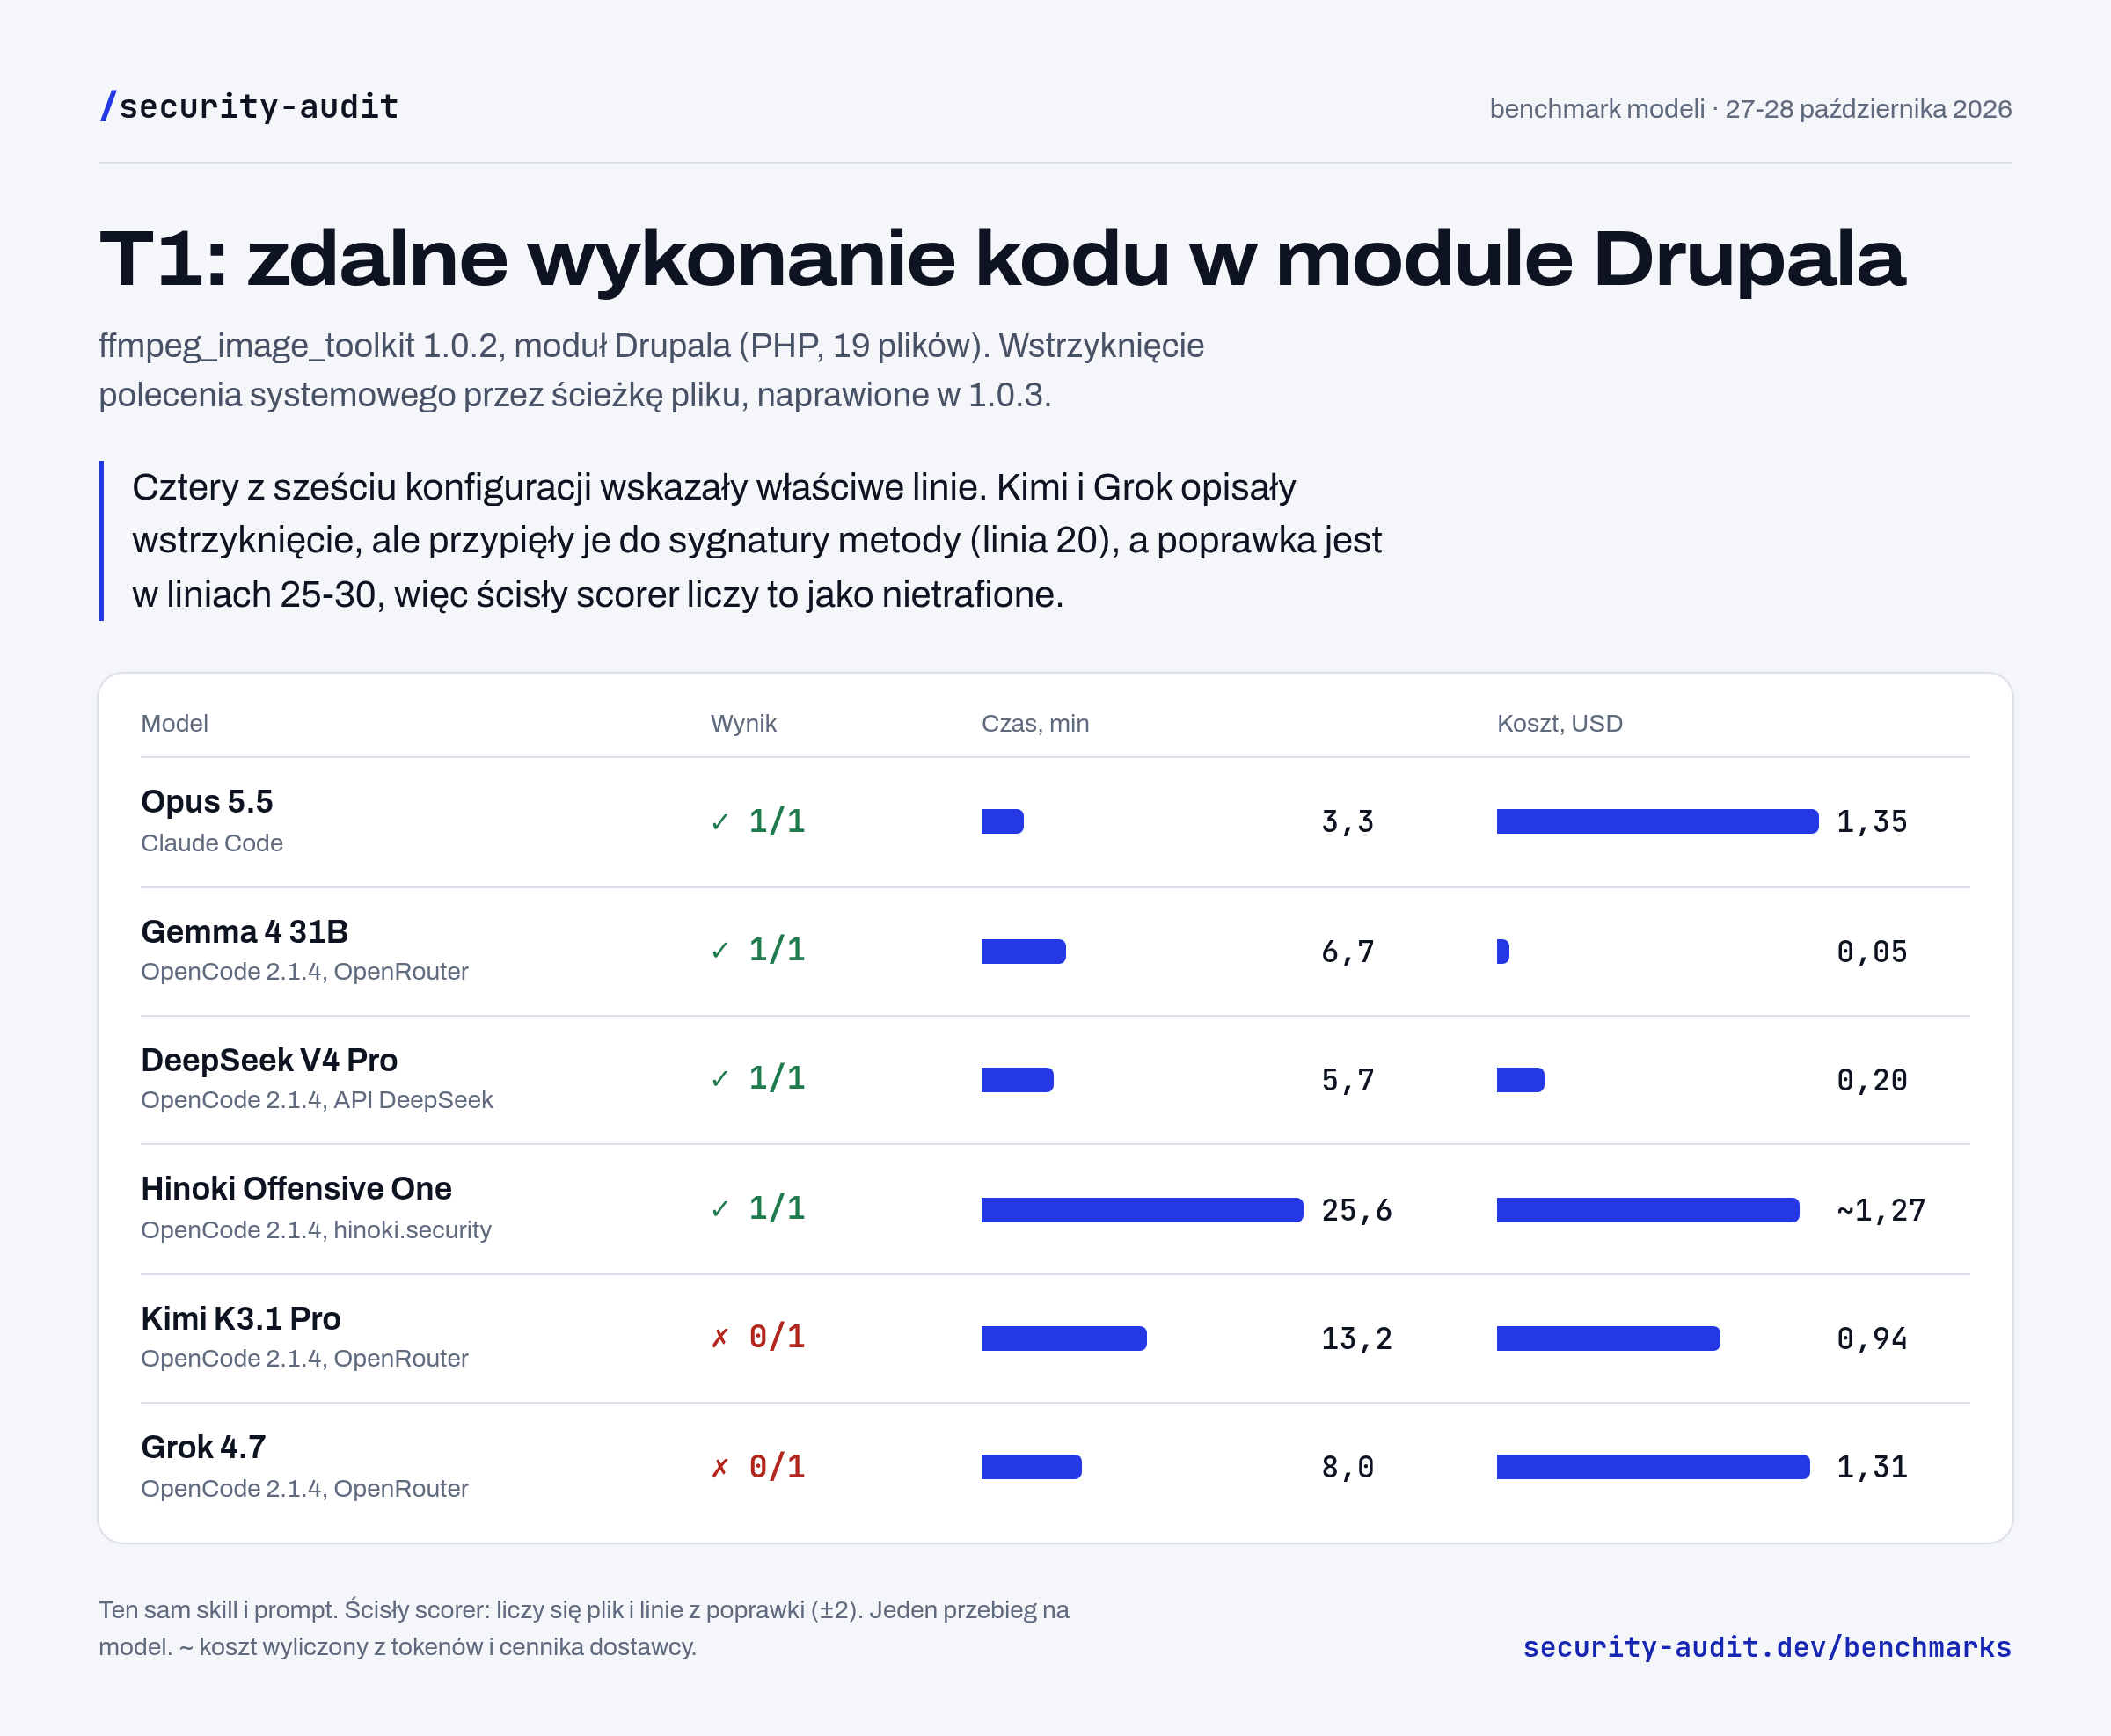
T1: zdalne wykonanie kodu w module Drupala
ffmpeg_image_toolkit 1.0.2, moduł Drupala (PHP, 19 plików). Wstrzyknięcie polecenia systemowego przez ścieżkę pliku, naprawione w 1.0.3.
Klucz: 1 advisory. Klucz to linie zmienione przez poprawkę w src/Ffmpeg.php. Bez pułapek. SA-CONTRIB-2026-220
Cztery z sześciu konfiguracji wskazały właściwe linie. Kimi i Grok opisały wstrzyknięcie, ale przypięły je do sygnatury metody (linia 20), a poprawka jest w liniach 25-30, więc ścisły scorer liczy to jako nietrafione.
| Model | Wynik | Spoza klucza | Czas min, mniej = lepiej | Koszt USD, mniej = lepiej |
|---|---|---|---|---|
| Opus 5.5Claude Code | 1/1 | 1 | ||
| Gemma 4 31BOpenCode 2.1.4, OpenRouter | 1/1 | 1 | ||
| DeepSeek V4 ProOpenCode 2.1.4, API DeepSeek | 1/1 | 0 | ||
| Hinoki Offensive OneOpenCode 2.1.4, hinoki.security | 1/1 | 1 | ||
| Kimi K3.1 ProOpenCode 2.1.4, OpenRouter | 0/1 | 2 | ||
| Grok 4.7OpenCode 2.1.4, OpenRouter | 0/1 | 1 |
- Hinoki był najdokładniejszy w przebiegu (217 wywołań narzędzi, 3 pliki testów), ale też najwolniejszy.
- Hinoki płaci za ten sam typ pracy więcej niż DeepSeek, bo czyta z cache kilka razy więcej tokenów: na T1 9,7 mln wobec 2,9 mln.
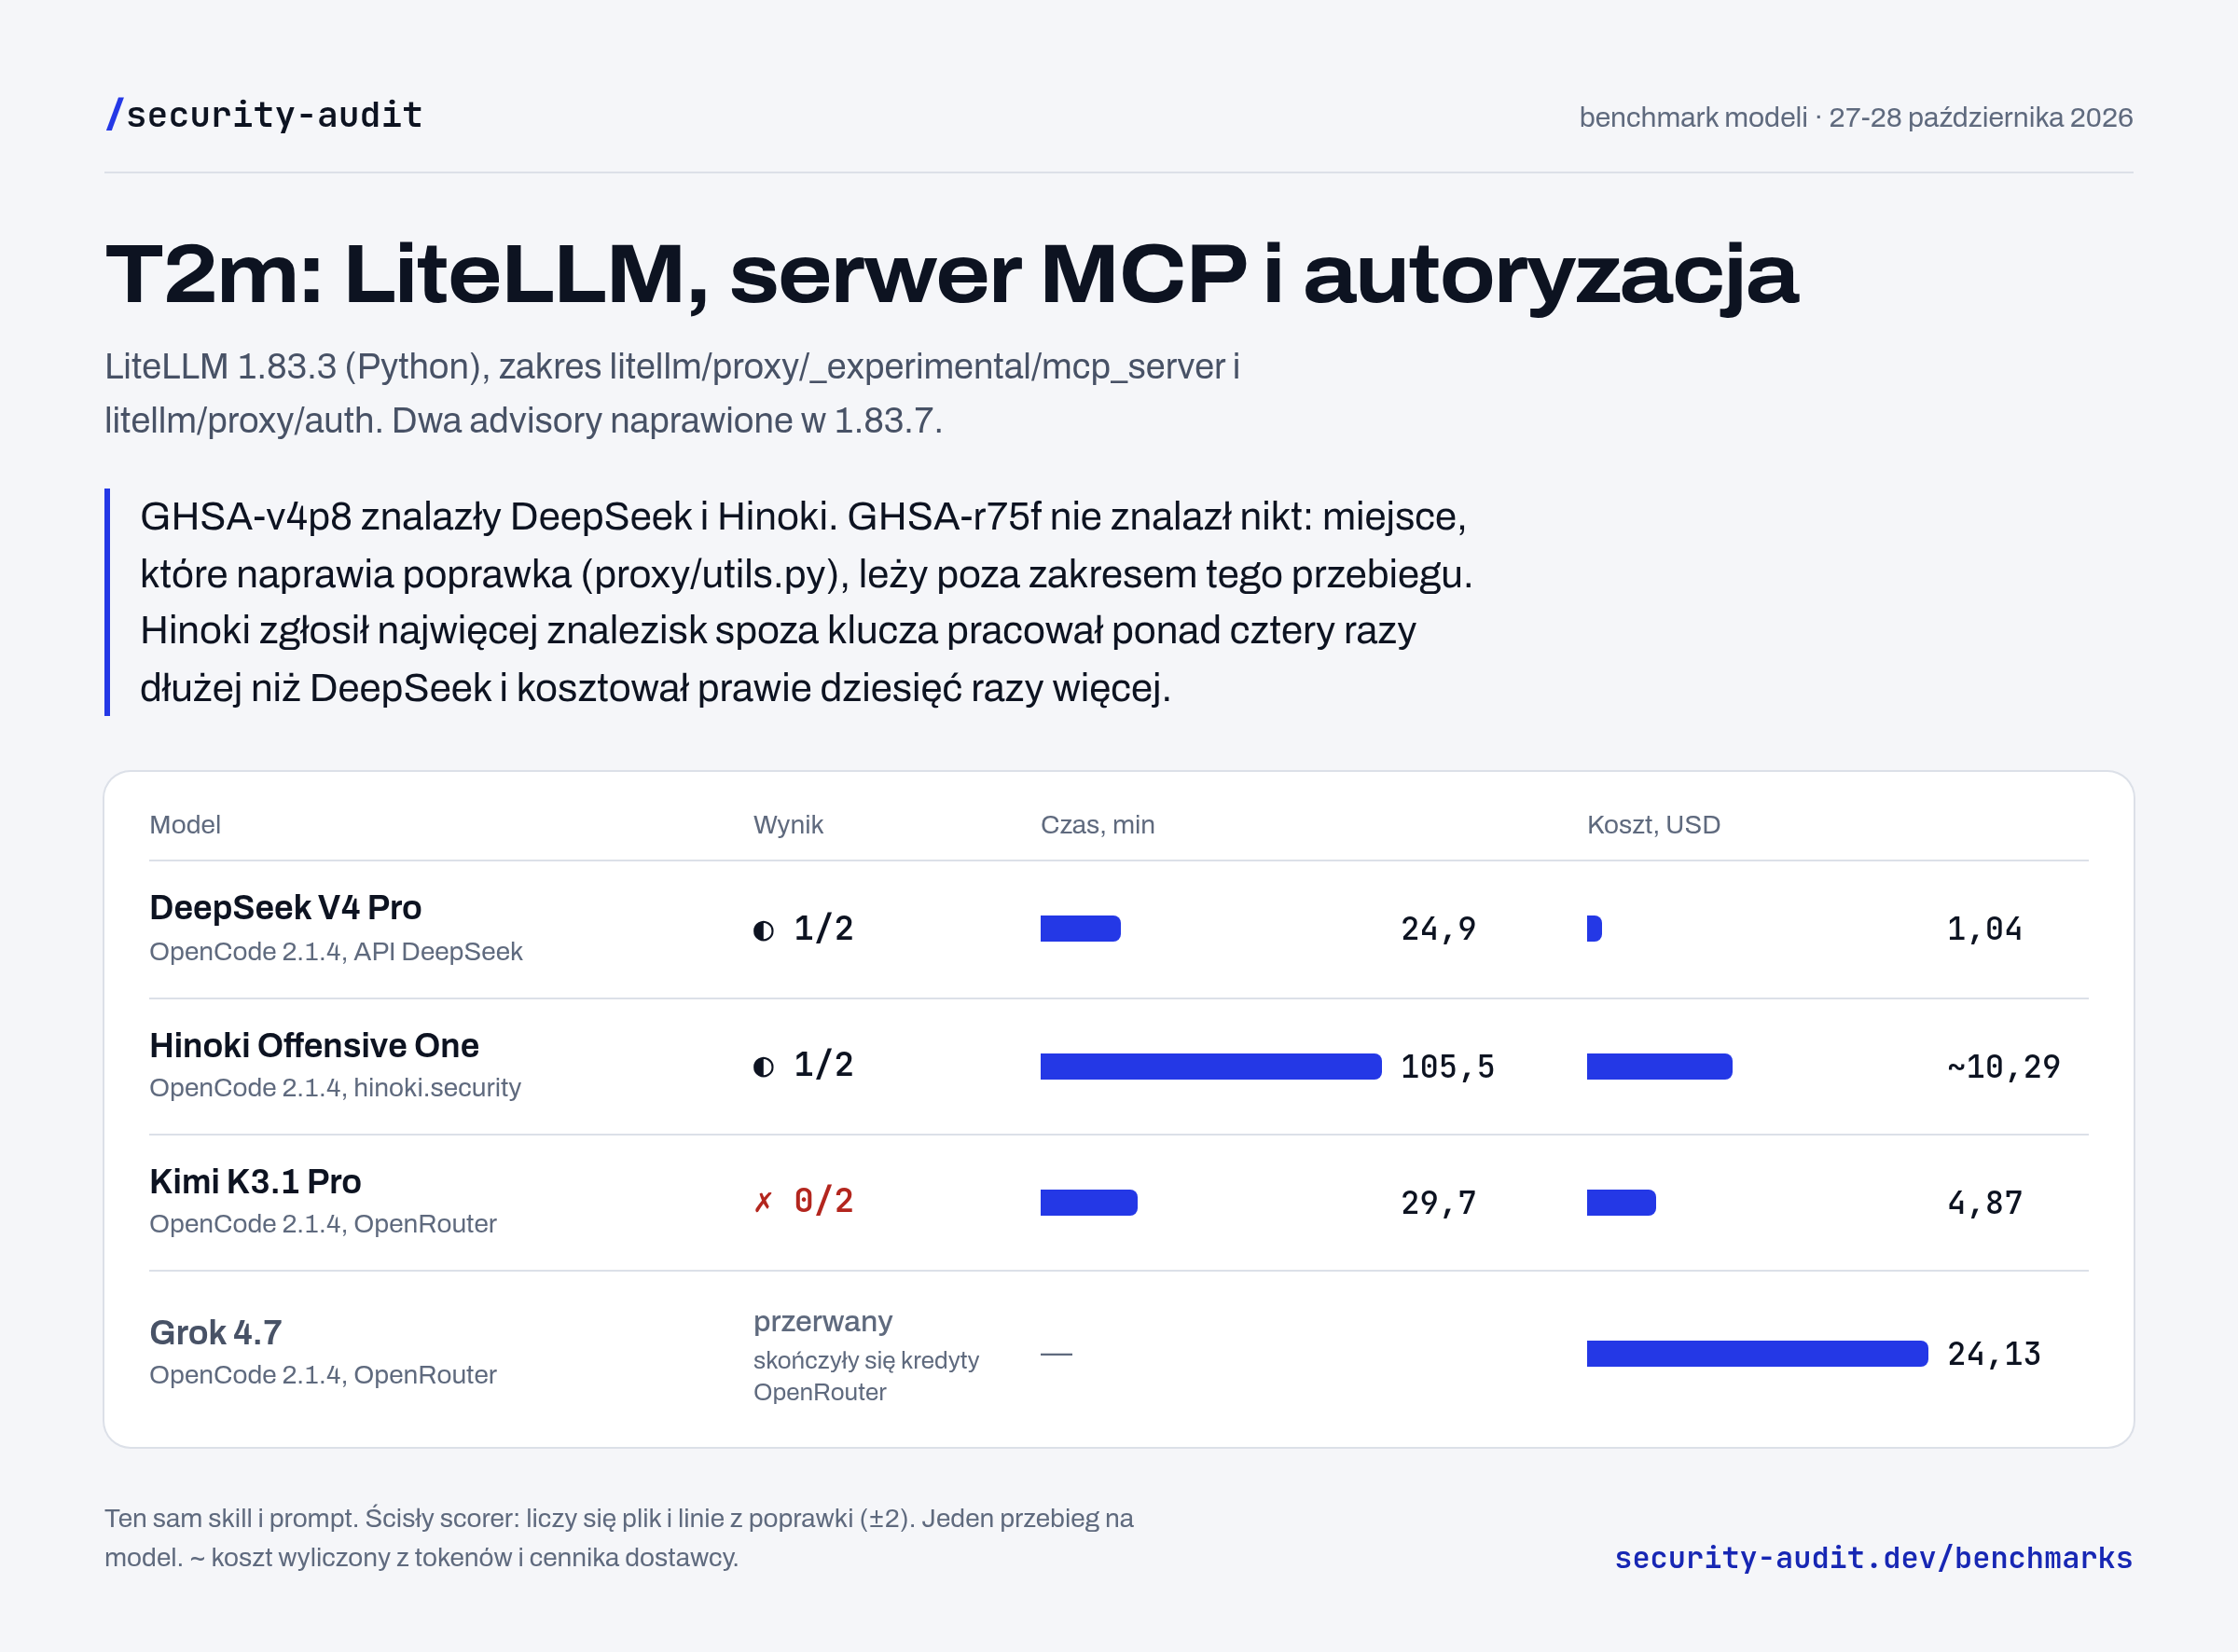
T2m: LiteLLM, serwer MCP i autoryzacja
LiteLLM 1.83.3 (Python), zakres litellm/proxy/_experimental/mcp_server i litellm/proxy/auth. Dwa advisory naprawione w 1.83.7.
Klucz: 2 advisory. Klucz to linie z poprawek. Bez pułapek. GHSA-v4p8-mg3p-g94g · GHSA-r75f-5x8p-qvmc
GHSA-v4p8 znalazły DeepSeek i Hinoki. GHSA-r75f nie znalazł nikt: miejsce, które naprawia poprawka (proxy/utils.py), leży poza zakresem tego przebiegu. Hinoki zgłosił najwięcej znalezisk spoza klucza pracował ponad cztery razy dłużej niż DeepSeek i kosztował prawie dziesięć razy więcej.
| Model | Wynik | Spoza klucza | Dowód testem | Czas min, mniej = lepiej | Koszt USD, mniej = lepiej |
|---|---|---|---|---|---|
| DeepSeek V4 ProOpenCode 2.1.4, API DeepSeek | 1/2 | 6 | — | ||
| Hinoki Offensive OneOpenCode 2.1.4, hinoki.security | 1/2 | 34 | 5 z 37 | ||
| Kimi K3.1 ProOpenCode 2.1.4, OpenRouter | 0/2 | 9 | — | ||
| Grok 4.7OpenCode 2.1.4, OpenRouter | przerwanyprzerwany przed raportem: skończyły się kredyty OpenRouter | — | — | — |
- Kimi opisał GHSA-v4p8, ale wskazał wspólną funkcję pomocniczą poza liniami poprawki, więc ścisły scorer liczy to jako nietrafione.
- Grok zużył 2,3 raza więcej tokenów niż DeepSeek, a odczyt z cache kosztuje u niego około 6 razy więcej. Bez raportu przebieg się nie liczy.
- Tego celu nie puszczaliśmy w Claude Code.
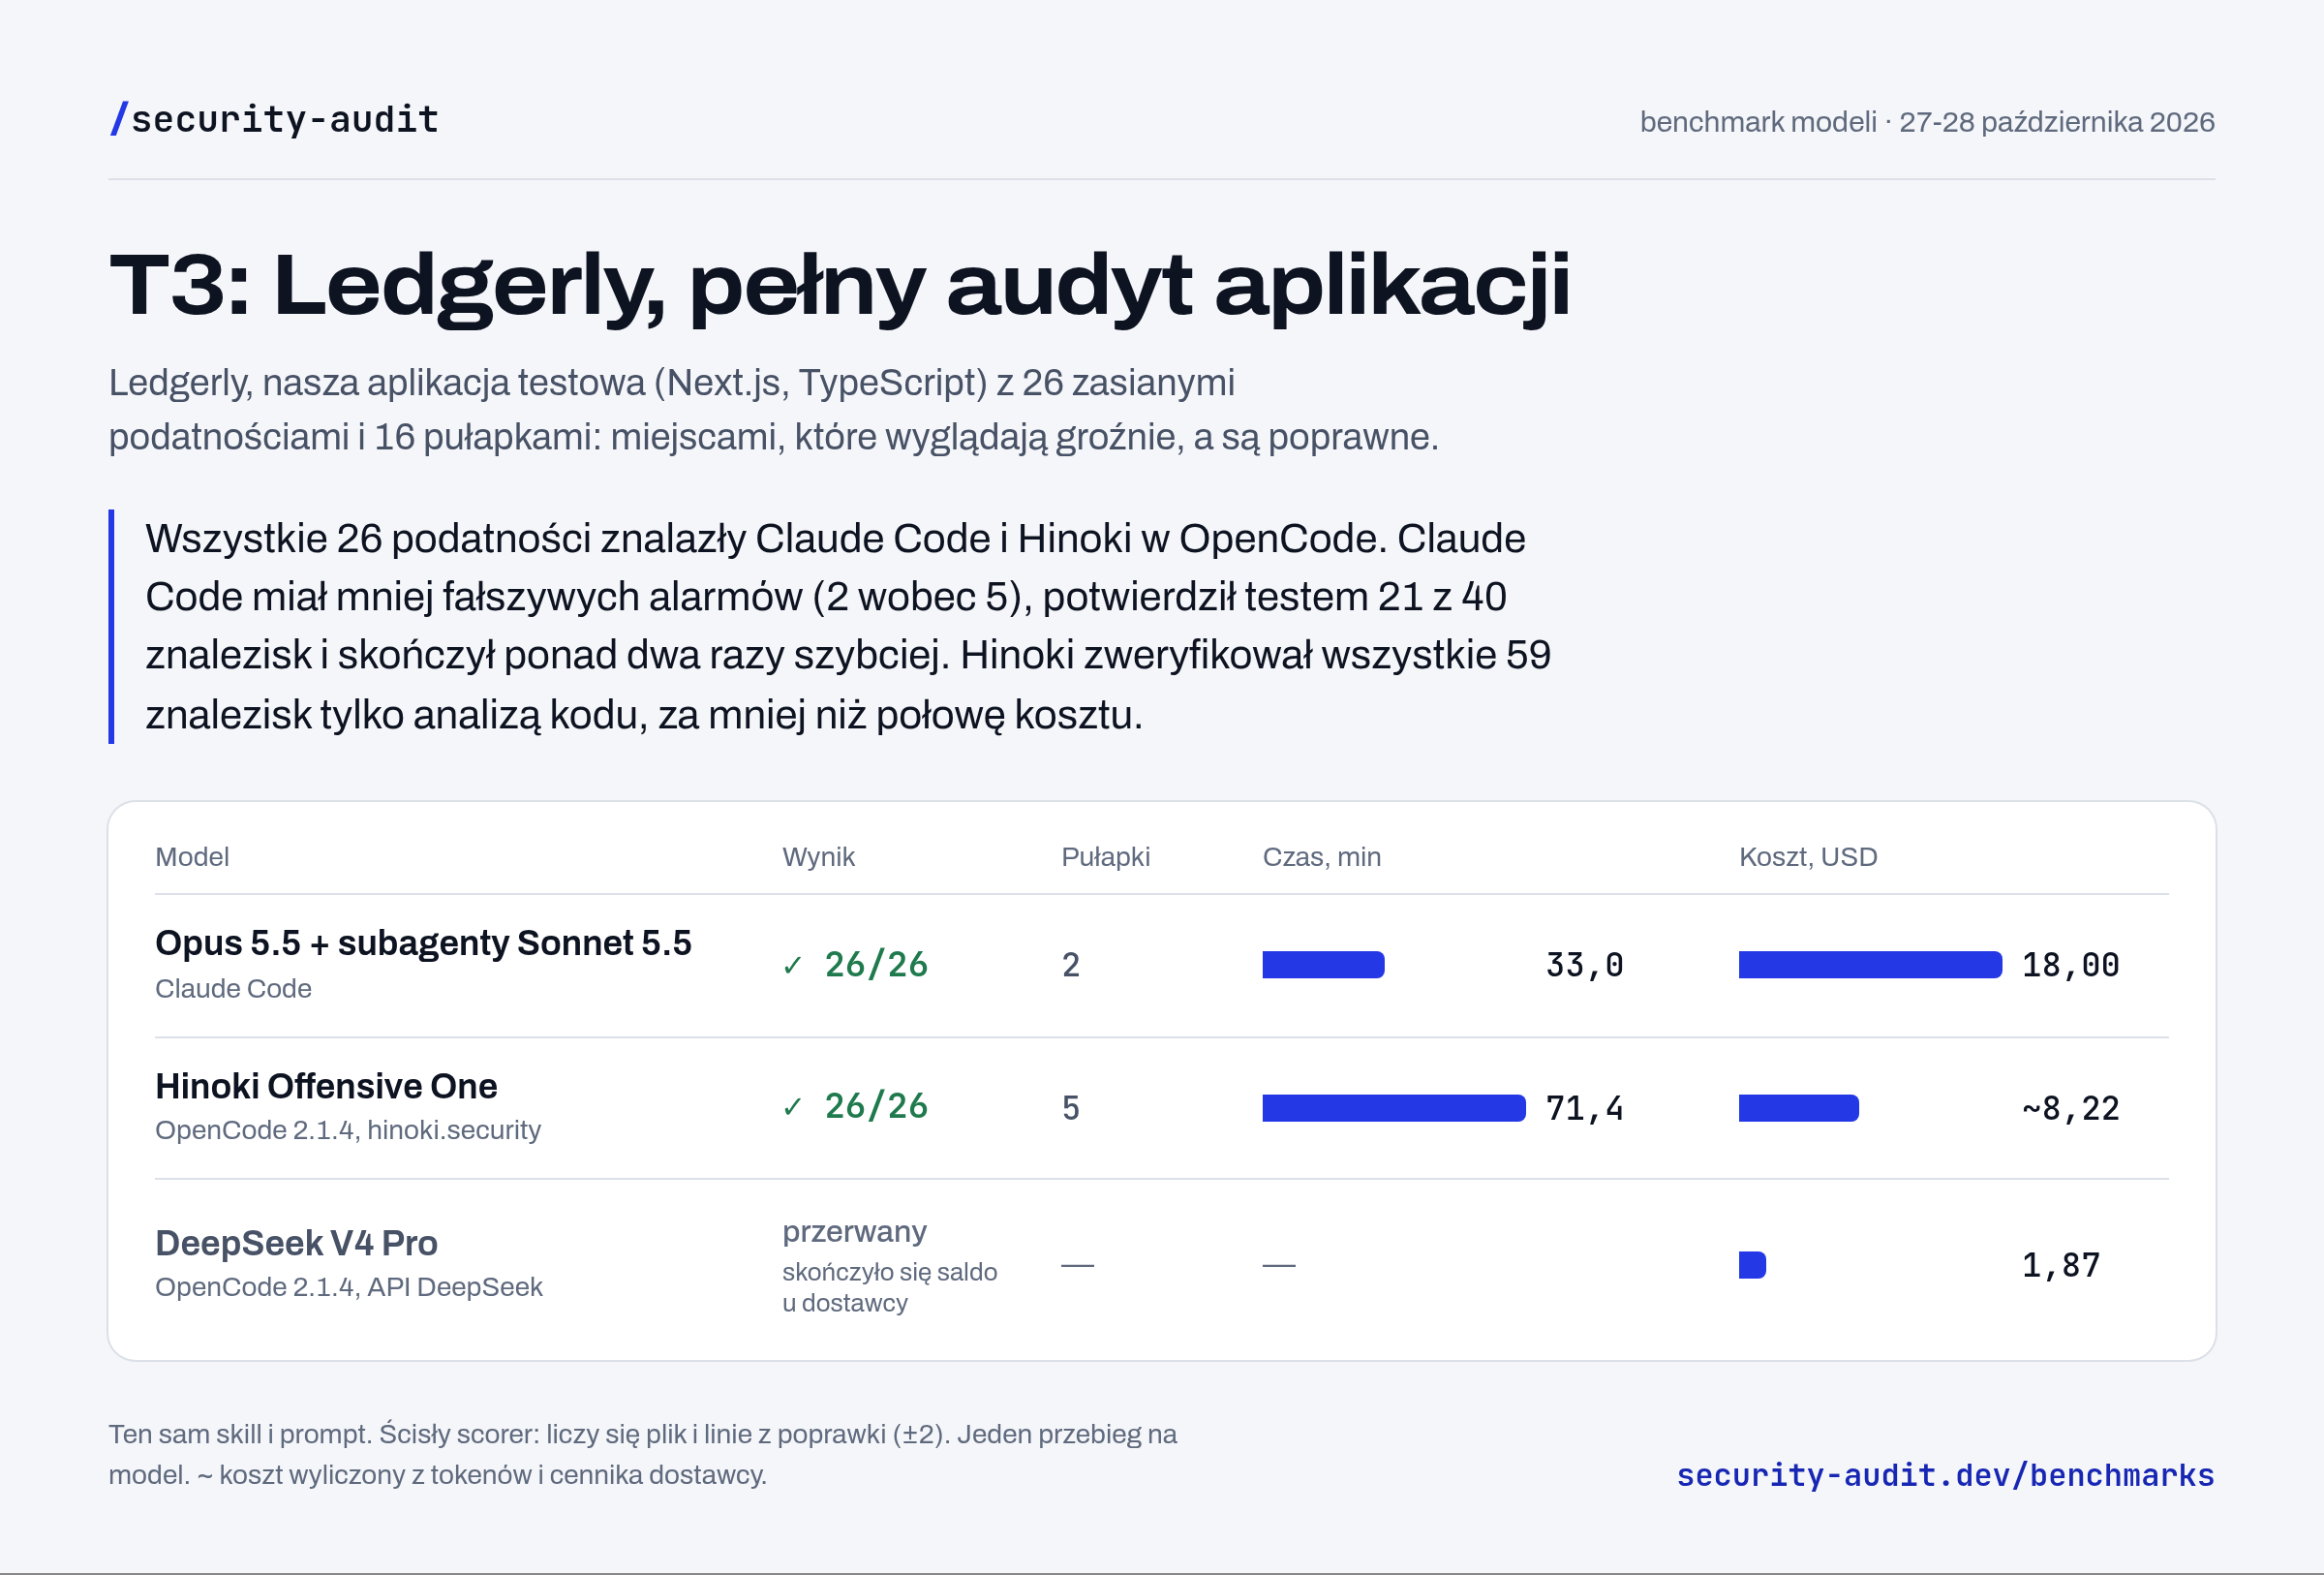
T3: Ledgerly, pełny audyt aplikacji
Ledgerly, nasza aplikacja testowa (Next.js, TypeScript) z 26 zasianymi podatnościami i 16 pułapkami: miejscami, które wyglądają groźnie, a są poprawne.
Klucz: 26 podatności i 16 pułapek. Trafienie w pułapkę to fałszywy alarm. benchmark/app
Wszystkie 26 podatności znalazły Claude Code i Hinoki w OpenCode. Claude Code miał mniej fałszywych alarmów (2 wobec 5), potwierdził testem 21 z 40 znalezisk i skończył ponad dwa razy szybciej. Hinoki zweryfikował wszystkie 59 znalezisk tylko analizą kodu, za mniej niż połowę kosztu.
| Model | Wynik | Pułapki | Spoza klucza | Dowód testem | Czas min, mniej = lepiej | Koszt USD, mniej = lepiej |
|---|---|---|---|---|---|---|
| Opus 5.5 + subagenty Sonnet 5.5Claude Code | 26/26 | 2 | 4 | 21 z 40 | ||
| Hinoki Offensive OneOpenCode 2.1.4, hinoki.security | 26/26 | 5 | 12 | 0 z 59 | ||
| DeepSeek V4 ProOpenCode 2.1.4, API DeepSeek | przerwanyprzerwany przed raportem: skończyło się saldo u dostawcy | — | — | — | — | |
| gpt-6-astra + 9 subagentówCodex CLI 0.155.1, plan ChatGPT | 21/26 | 1 | 2 | 0 z 25 | — |
- To pierwszy pełny przebieg Ledgerly w OpenCode. Zanim DeepSeek się zatrzymał, częściowe znaleziska dawały 26/26 bez trafień w pułapki, ale bez raportu przebieg się nie liczy.
- Wszystkie trafienia w pułapki, u obu modeli, to znaleziska o innym problemie w tych samych liniach (współbieżność, brak rotacji kluczy API, role w organizacji, brak logów bezpieczeństwa). Żadne nie twierdzi, że chroniona kontrola jest zepsuta.
- Codex CLI (30 października 2026, jeden przebieg) szedł na planie ChatGPT, więc nie ma kosztu per przebieg; zużył ok. 10 mln tokenów wejścia, prawie wszystko z cache. Szedł z hookiem strażnika i bez sieci: osv-scanner i gitleaks się nie uruchomiły, stąd dwa z czterech pudeł (podatna wersja Next.js, sekret w historii gita). Pozostałe dwa: skrypt instalacyjny pobierający zdalny skrypt i HTML z odpowiedzi modelu. Testów nie dało się uruchomić (brak vitest bez sieci), więc wszystkie dowody są z analizy kodu.
- Ledgerly jest publiczny od października 2026, a skill powstawał na nim. Wynik pokazuje, że skill pokrywa te klasy błędów. Nie mówi, jak model radzi sobie z nieznanym kodem.
T4: py-clinic w Codex CLI
py-clinic, nasza aplikacja testowa w Pythonie (Django, FastAPI i Flask, 48 plików) z 18 zasianymi podatnościami i 18 pułapkami.
Klucz: 18 podatności i 18 pułapek. Trafienie w pułapkę to fałszywy alarm. benchmark/py-clinic
Bez hooka strażnika Codex znalazł 17 z 18 podatności bez fałszywych alarmów. W obu przebiegach ze strażnikiem znalazł 12. Większość brakujących to znaleziska, które są w raporcie, ale wskazują początek funkcji zamiast linii z błędem (3-4 linie wcześniej), więc ścisły scorer ich nie liczy.
| Model | Wynik | Pułapki | Spoza klucza | Dowód testem | Czas min, mniej = lepiej | Koszt USD, mniej = lepiej |
|---|---|---|---|---|---|---|
| gpt-6-astra, bez strażnikaCodex CLI 0.155.1, plan ChatGPT | 17/18 | 0 | 0 | 0 z 18 | — | |
| gpt-6-astra, strażnik v1Codex CLI 0.155.1, plan ChatGPT | 12/18 | 1 | 6 | 0 z 19 | — | |
| gpt-6-astra, strażnik v2Codex CLI 0.155.1, plan ChatGPT | 12/18 | 0 | 6 | 0 z 19 | — |
- Trzy przebiegi z 30 października 2026, po jednym na konfigurację. Plan ChatGPT, więc bez kosztu per przebieg: 0,8–1,6 mln tokenów wejścia, ponad 90% z cache.
- Strażnik v2 poprawia fałszywe blokady z v1. Najważniejsza: audyt znowu dopisuje .security-audit/ do .gitignore.
- Bez sieci i bez Django w środowisku testy się nie uruchomiły, wszystkie dowody są z analizy kodu.
Jak mierzymy
- Ten sam skill. Commit 46910ca. Trzy pierwsze przebiegi T1 szły na wcześniejszych commitach, które różnią się tylko strażnikiem ścieżek w OpenCode.
- Agent. W OpenCode 2.1.4 jeden model gra wszystkie role: głównego audytora i subagentów. Claude Code dobiera modele sam: na T1 był to sam Opus 5.5, na T3 Opus 5.5 z subagentami Sonnet 5.5.
- Izolacja. Każdy przebieg w świeżym katalogu, w nowej sesji, bez wspólnej pamięci. Strażnik odmawia czytania poza katalogiem przebiegu. Logi sprawdziliśmy: żaden model nie widział klucza ani innych przebiegów.
- Ścisły scorer. Znalezisko musi wskazać plik i linie z poprawki, z tolerancją ±2 linii. Klucze ustaliliśmy przed przebiegami i nie poszerzamy ich pod odpowiedzi modeli.
- Koszt. Dla OpenCode to ceny z cennika dostawcy zapisane przy przebiegu. Dla Claude Code to zużyte tokeny przeliczone po cenach API, nie koszt abonamentu. OpenCode nie zna ceny Hinoki, więc jego koszt (z „~”) wyliczyliśmy z zapisanych tokenów i cennika, który zwraca API Hinoki: 0,80 USD za milion tokenów wejścia, 0,08 z cache, 1,20 wyjścia.
- Spoza klucza. Zweryfikowane znaleziska, których nie ma w kluczu, podajemy tylko liczbą. W kodzie open source mogą to być prawdziwe, nieujawnione błędy, więc najpierw przeglądamy je ręcznie.
Czego to nie mówi
- Jeden przebieg na model i cel. Małe różnice w czasie i koszcie traktuj jak szum.
- Ścisły scorer zaniża błędy typu „brakuje sprawdzenia”, bo nie mają jednej oczywistej linii. Dwa nietrafienia na T1 i jedno na T2m to dobry opis w złym miejscu.
- Ledgerly to nasza publiczna aplikacja testowa, na której powstawał skill. 26/26 znaczy, że skill pokrywa te klasy błędów, a nie że model tak samo poradzi sobie w nieznanym kodzie.
- Kod idzie do dostawcy modelu. Do kodu klientów używaj tylko dostawcy, któremu ufasz na piśmie.
Przebiegi samego skilla w Claude Code na prawdziwych modułach są na stronie Przebiegi. Jak zainstalować skill w OpenCode: Instalacja.
Grafiki do udostępnienia: T1, T2m, T3, wszystkie trzy.